RAG 解决了什么问题
大语言模型拥有强大的语言理解和生成能力,但它的知识主要来自训练数据,无法自动获取最新信息,也不一定了解企业内部资料。
RAG 通过在生成答案之前检索外部知识,为 LLM 提供额外上下文,成为增强模型可靠性的重要方法。
但传统 RAG 通常采用一次检索、一次生成的流程。
用户提出问题,系统生成查询,从知识库中找到若干结果,再将这些结果交给模型生成答案。这种方式适合简单问题,却难以处理需要多步搜索和证据验证的复杂任务。
一次检索为什么不够
现实中的问题往往并不是一个简单事实。
用户可能需要比较多个产品,分析一项政策的影响,调查一个技术问题的历史原因,或者根据多个来源完成复杂判断。
这类任务通常需要多个搜索步骤。
Agent 可能先检索一个概念,再根据检索结果找到相关人物、事件或文档,最后通过多个来源进行交叉验证。 如果系统只执行一次检索,它很可能在没有充分证据的情况下直接生成答案。
Agentic Retrieval 的核心
Agentic Retrieval 将检索过程交给 AI Agent 管理。
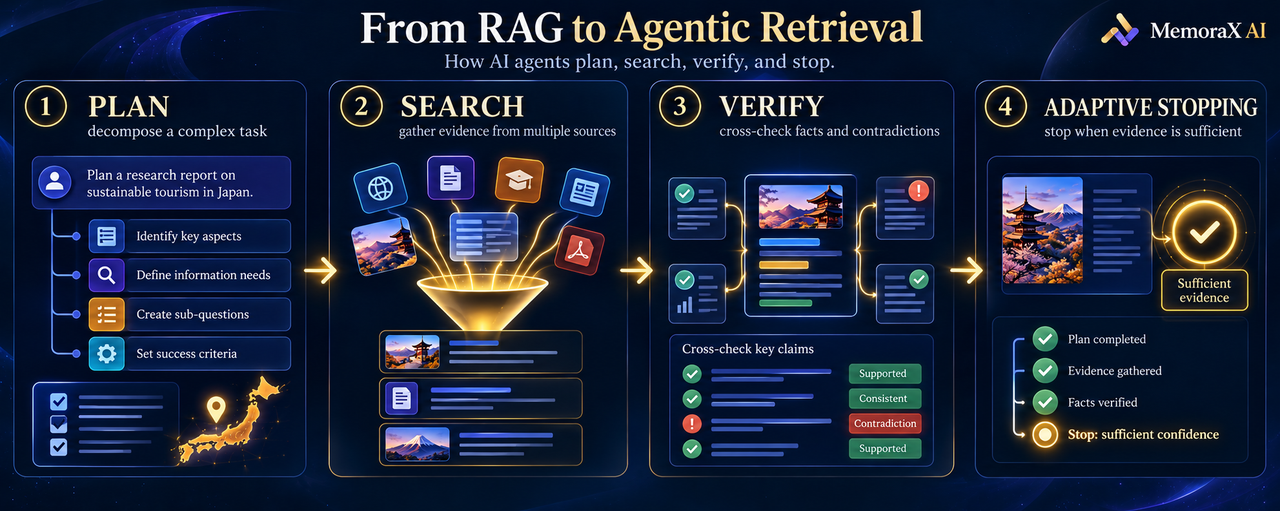
Agent 不只是执行一个搜索请求,而是需要先分析任务,判断需要哪些信息,再决定调用什么工具、检索哪些来源以及是否需要继续搜索。
这意味着检索过程包含多个决策:
Agent 需要生成查询计划,需要根据结果修改查询,还需要判断当前信息是否足以支持结论。
相比传统 RAG,Agentic Retrieval 更接近一个自主的信息获取系统。
查询规划
复杂问题通常需要拆分成多个子问题。
例如,一个企业希望判断某项 LLM 技术是否适合内部部署,Agent 可能需要分别检索模型能力、硬件要求、成本、数据隐私和部署案例。
如果没有查询规划,系统可能只围绕一个关键词搜索,最终得到的内容不完整。
Agent 可以先生成任务计划,再按照优先级逐步完成查询。
证据验证
检索到的信息并不一定准确。
不同来源可能存在冲突,某些内容可能已经过时,也有些网页只提供了片面的结论。
因此,Agent 需要对检索结果进行验证。它需要判断来源是否可信,不同来源是否相互支持,以及当前证据是否能够支撑最终答案。
当多个来源出现矛盾时,系统应该继续检索,或者在回答中明确说明不确定性,而不是直接选择一个结果。
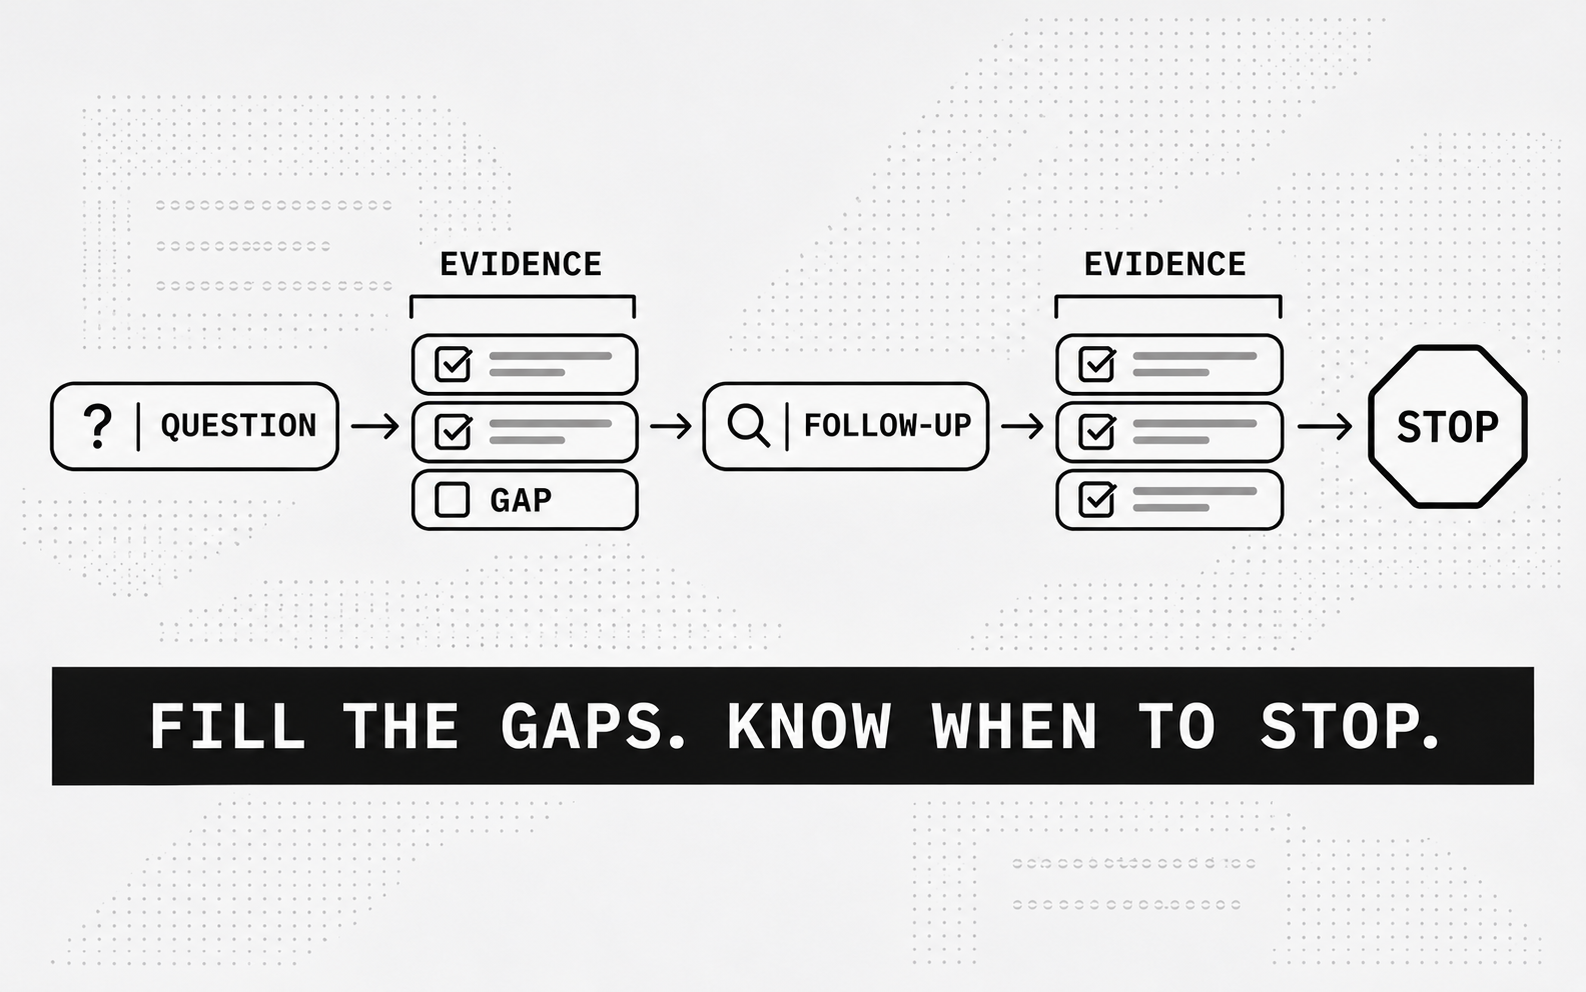
动态停止
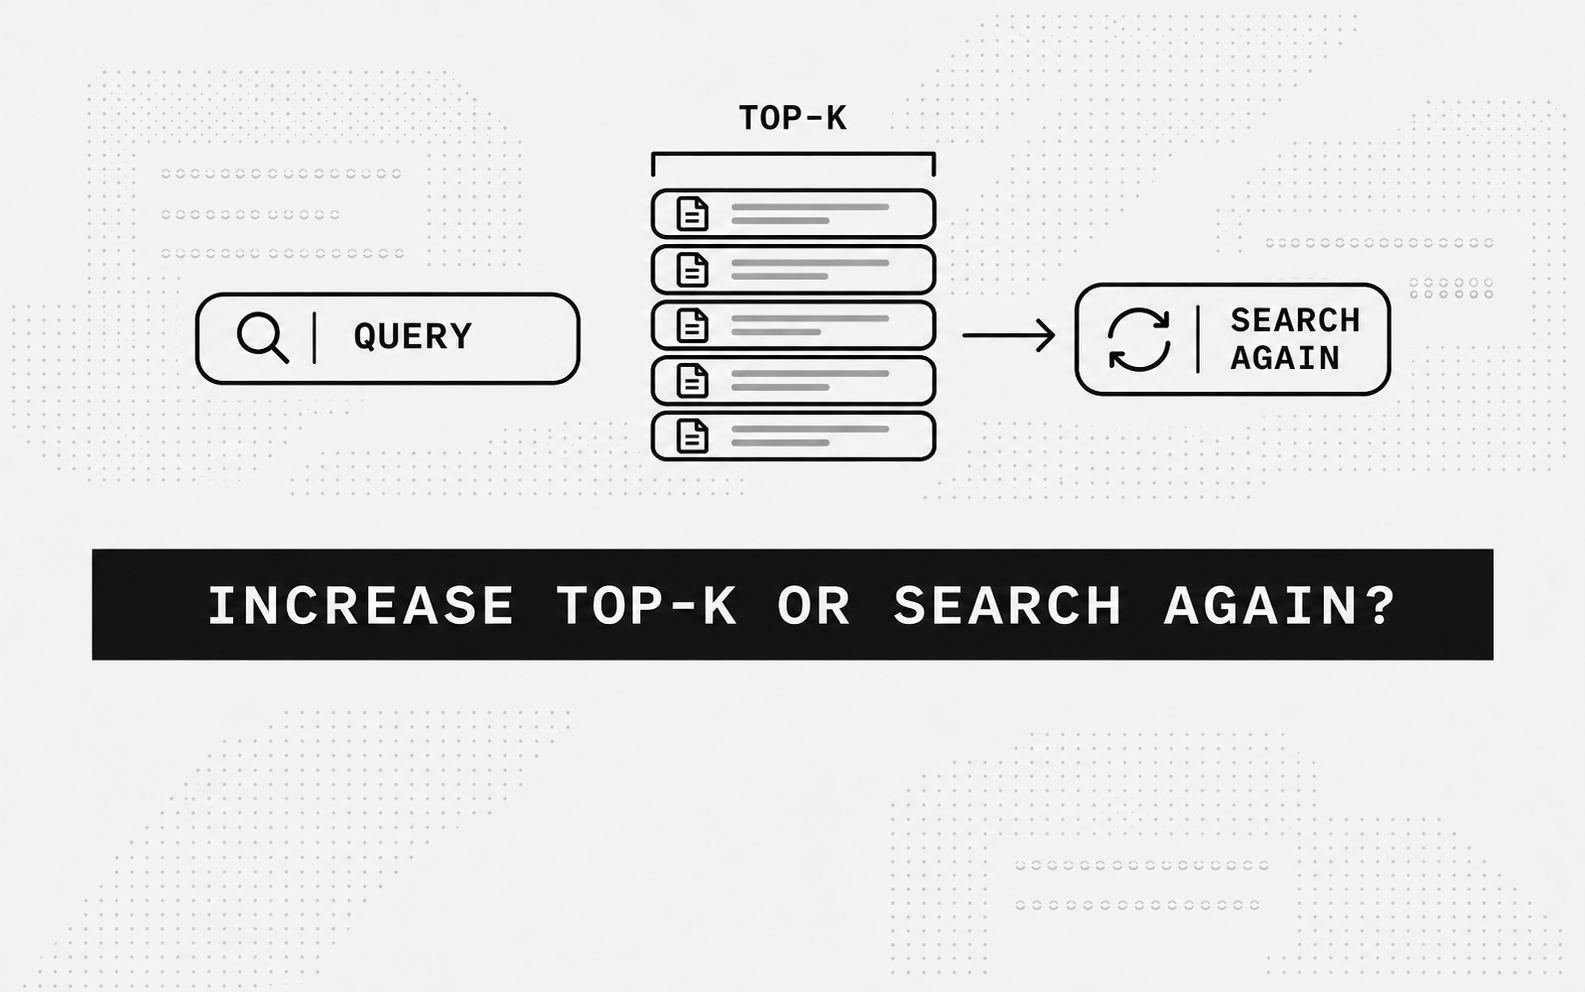
搜索过程需要一个合理的停止机制。
如果 Agent 不断搜索,就会产生过高的延迟和成本;如果过早停止,则可能遗漏关键证据。
Adaptive Stopping 让 Agent 根据当前证据质量决定是否继续检索。
当问题中的关键部分都已经被覆盖,新增信息不再带来明显收益时,系统就可以停止搜索并生成答案。
Agentic Retrieval 与 Agent Memory
Agentic Retrieval 和 Agent Memory 并不是两个完全独立的方向。
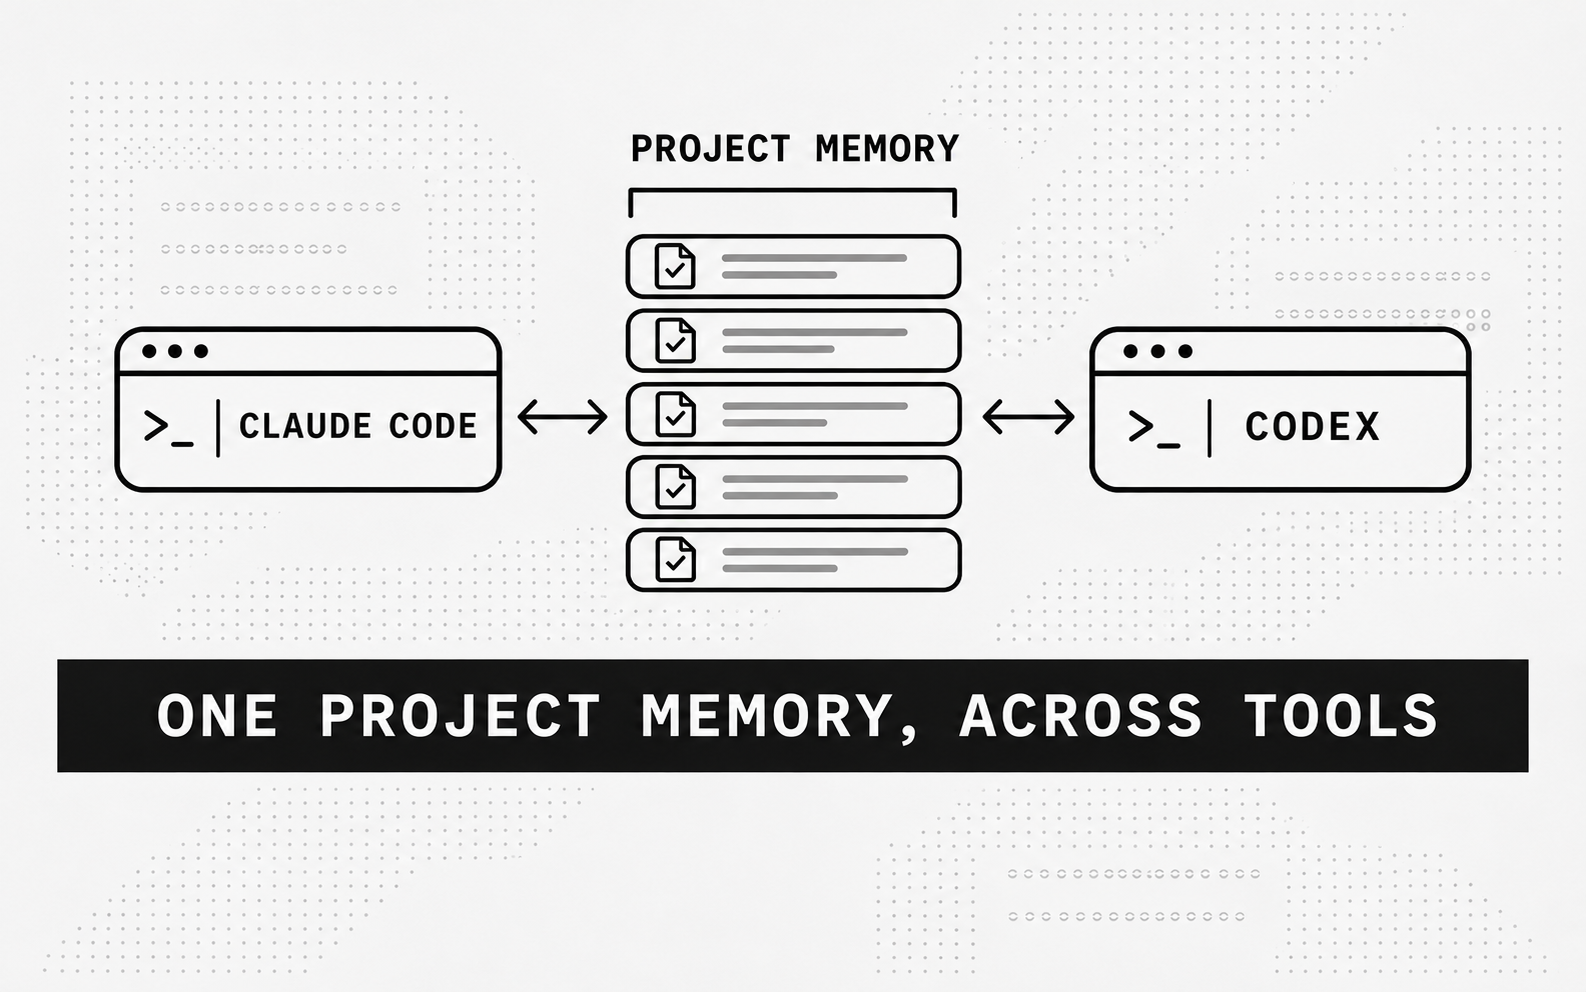
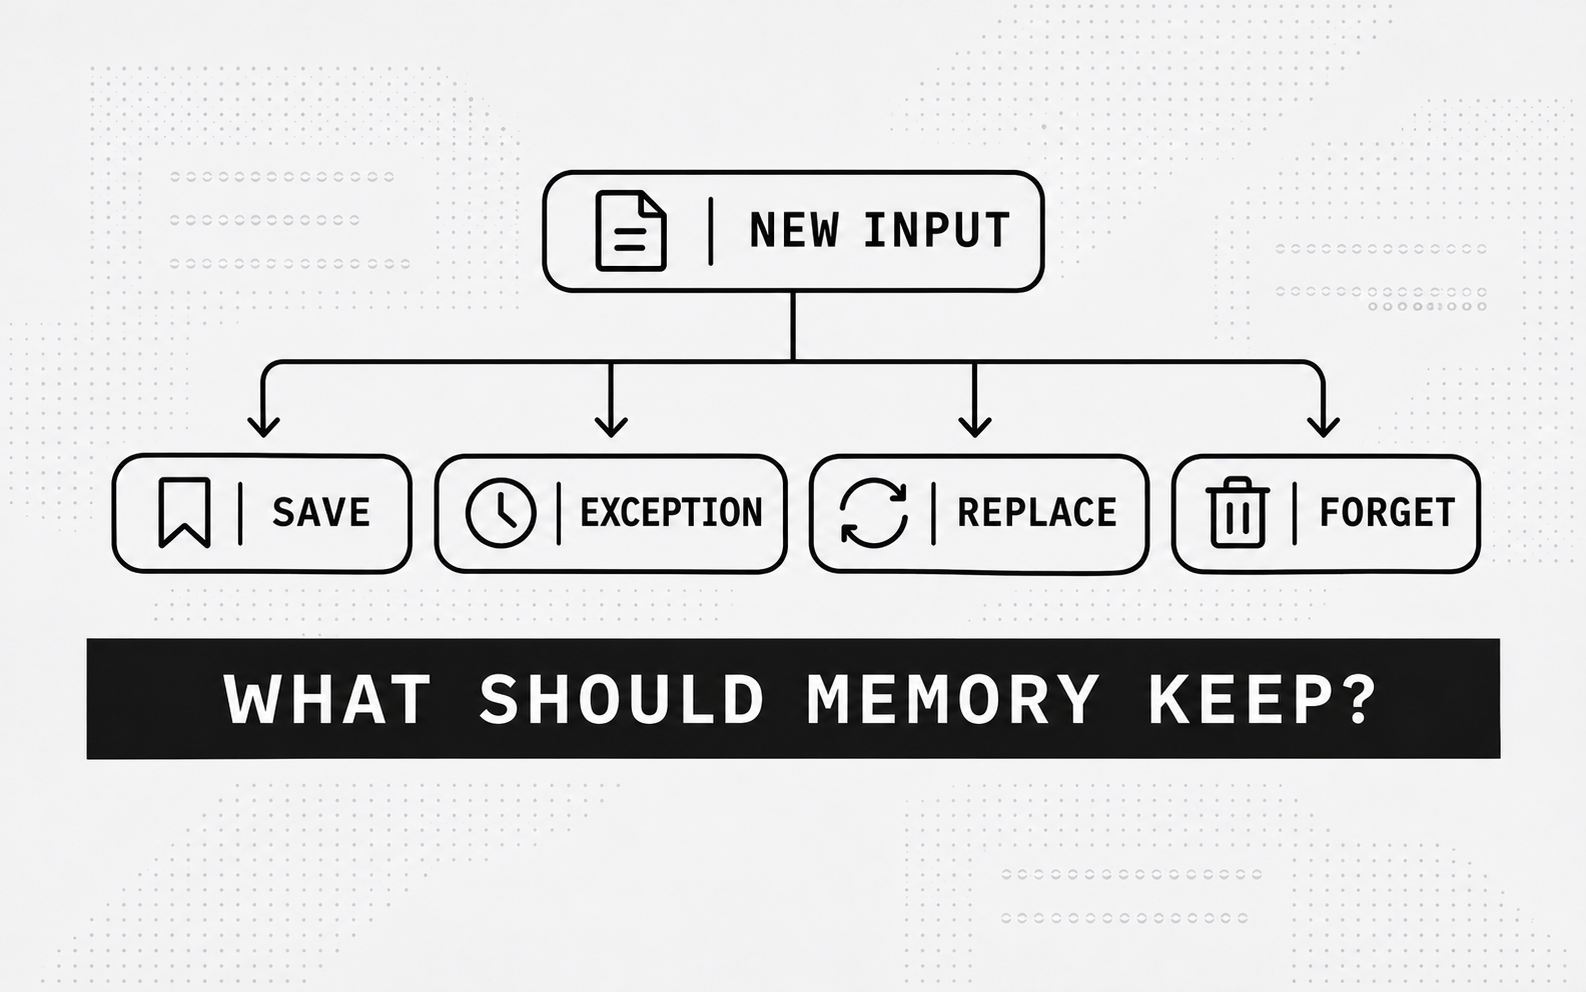
Memory 负责保存和组织历史信息,Retrieval 负责在当前任务中找到需要的信息。对于长期运行的 AI Agent 来说,系统还需要判断当前检索结果是否值得被写入未来的记忆。
这意味着一个完整的 Agent 系统应该能够处理完整的信息循环: 从历史记忆中检索信息,使用信息完成任务,根据任务结果评估信息价值,再将新的经验写回 Memory。
RAG 让 LLM 能够使用外部知识,Agentic Retrieval 则进一步让 Agent 具备自主获取和验证知识的能力。
MemoraX AI 关注 AI Agent、Agent Memory 和 LLM 推理之间的协同,希望让 Agent 不只是被动接收搜索结果,而是能够规划、验证和管理整个信息获取过程。