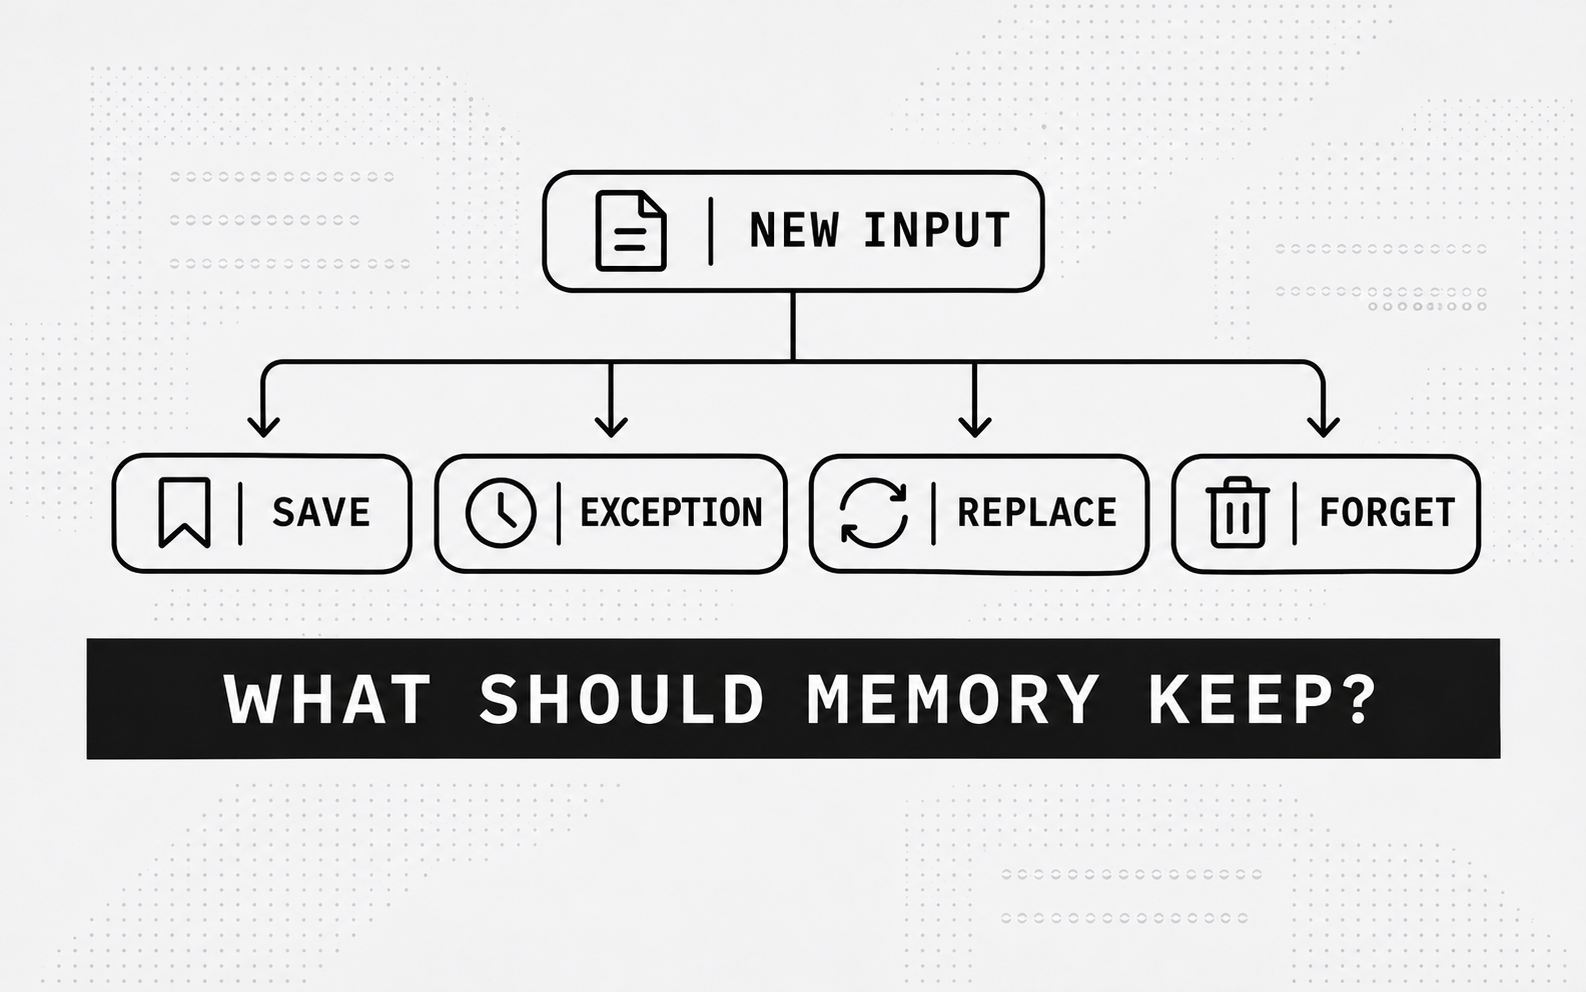
保存所有信息并不会带来真正的记忆
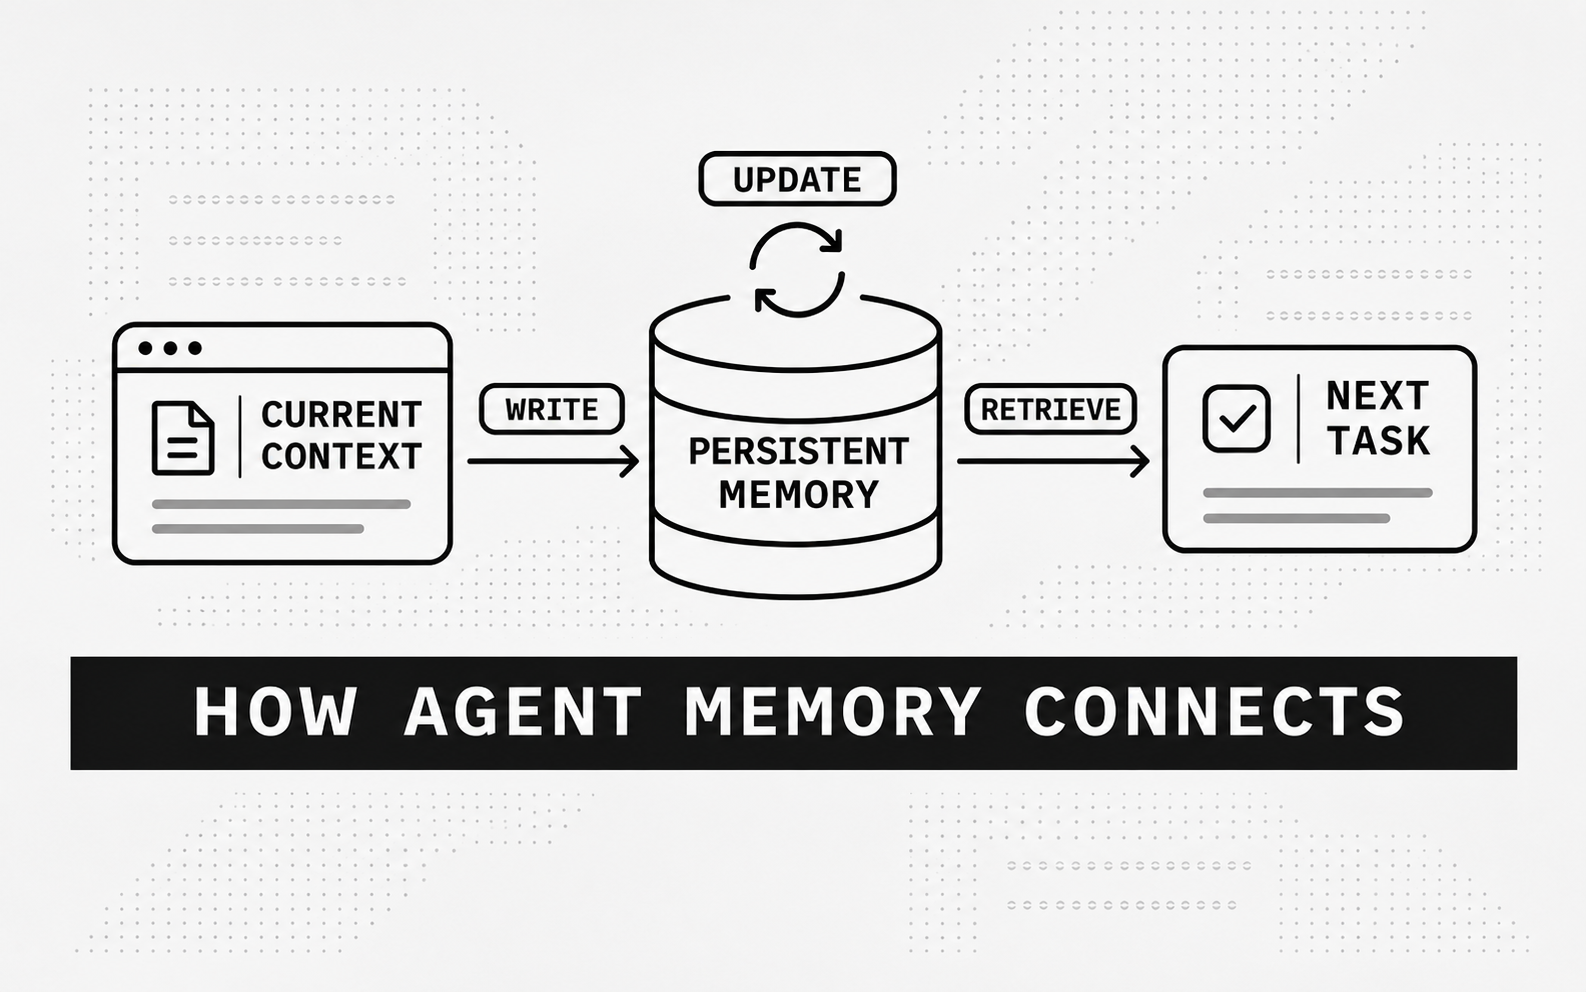
当人们讨论 AI Agent 的长期记忆时,最容易想到的是数据库。
只要把历史对话、用户资料和任务记录全部保存下来,系统是不是就能在需要时找到答案?
实际情况并没有这么简单。
如果 Agent 把所有内容都写入长期记忆,系统会快速积累重复信息、临时信息和已经过时的内容。随着记忆规模增长,检索难度也会增加,模型更容易受到噪声干扰。
因此,Long-Term Memory 的核心问题并不是“能保存多少”,而是: 什么信息值得长期保留?
记忆选择比记忆容量更重要
一条信息是否应该进入长期记忆,通常取决于它是否会影响未来任务。
用户一次性的临时要求,可能只需要保存在当前任务中;用户反复确认的工作习惯,则可能应该被保存为长期偏好;项目中的固定技术规则,则需要被长期维护。
一个有效的 Memory 系统需要判断信息的稳定性、重要性、重复出现频率和未来使用价值。
这也是 AI Agent Memory 与普通聊天记录之间的区别。
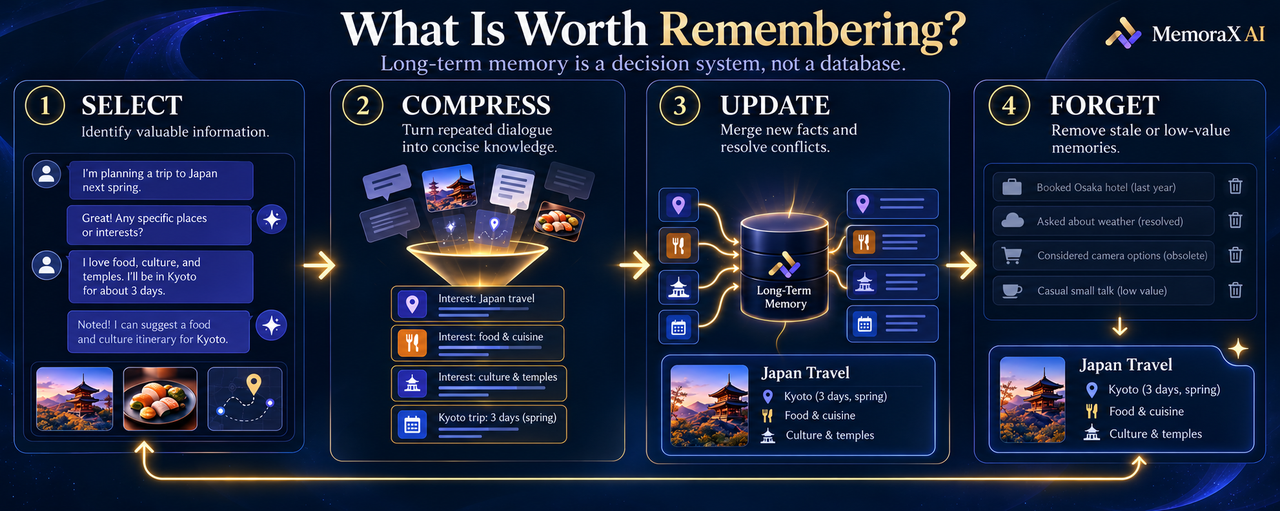
记忆压缩:从对话变成知识
长期交互会产生大量重复内容。
如果系统保存每一轮对话的原文,Memory 很快会变成一个巨大的日志系统。Agent 需要将多轮对话压缩成更稳定、更容易检索的知识。
例如,用户可能在多次对话中逐渐表达了对输出格式、工作时间和沟通方式的偏好。系统没有必要保存所有原句,而可以将这些信息归纳成一条经过验证的用户偏好。
记忆压缩能够降低存储和检索成本,但也需要防止过度总结导致重要细节丢失。
记忆合并与冲突处理
不同时间产生的记忆可能属于同一个主题。
用户过去喜欢简短回答,后来又要求在技术问题中提供详细解释。这两条信息并不一定完全冲突,而可能代表不同场景下的偏好。
因此,Agent 不能简单地用新记忆覆盖旧记忆,而需要考虑时间、上下文和使用场景。
高质量的 Memory 系统需要知道:
- 哪条信息更新;
- 哪条信息适用于特定场景;
- 两条记忆是否可以合并;
- 冲突是否需要向用户确认。
过时信息与遗忘机制
并非所有记忆都应该永久保存。
用户的职位可能发生变化,项目的接口可能被重构,企业政策也可能更新。如果系统始终保留旧信息,Agent 就可能继续提供错误建议。
因此,Long-Term Memory 需要具备遗忘或降权机制。
一条记忆如果长期没有被使用,已经被新信息明确替代,或者与当前事实产生冲突,就应该被降低优先级,必要时从长期记忆中移除。
遗忘并不意味着系统失去能力,而是帮助 Agent 保持记忆质量。
记忆的来源和可信度
一条记忆除了内容本身,还应该记录来源和时间。
这条信息是用户明确确认的,还是 Agent 自己推断的?它是在昨天产生的,还是几个月前产生的?它是否被多次验证过?
这些信息会直接影响 Agent 如何使用记忆。
例如,一条用户刚刚确认的偏好应该具有较高优先级,而一条模型根据上下文推测出来的信息,则应该被谨慎使用。
如何评估 Long-Term Memory
长期记忆的质量不能只看保存了多少内容。
更加重要的指标包括:检索是否准确,记忆是否真正帮助任务完成,过时信息比例是否过高,重复记忆是否被有效压缩,以及系统能否根据新反馈及时更新。
一个好的 Memory 系统,应该让 Agent 更准确、更稳定、更个性化,而不是让数据库不断膨胀。
Long-Term Memory 不是聊天记录,也不是一个只负责保存内容的数据库。
它是一个持续进行选择、压缩、合并、更新和遗忘的动态系统。
MemoraX AI 关注的 Agent Memory 研究,希望让 LLM Agent 不仅能够记住过去,还能够判断哪些过去值得影响未来。