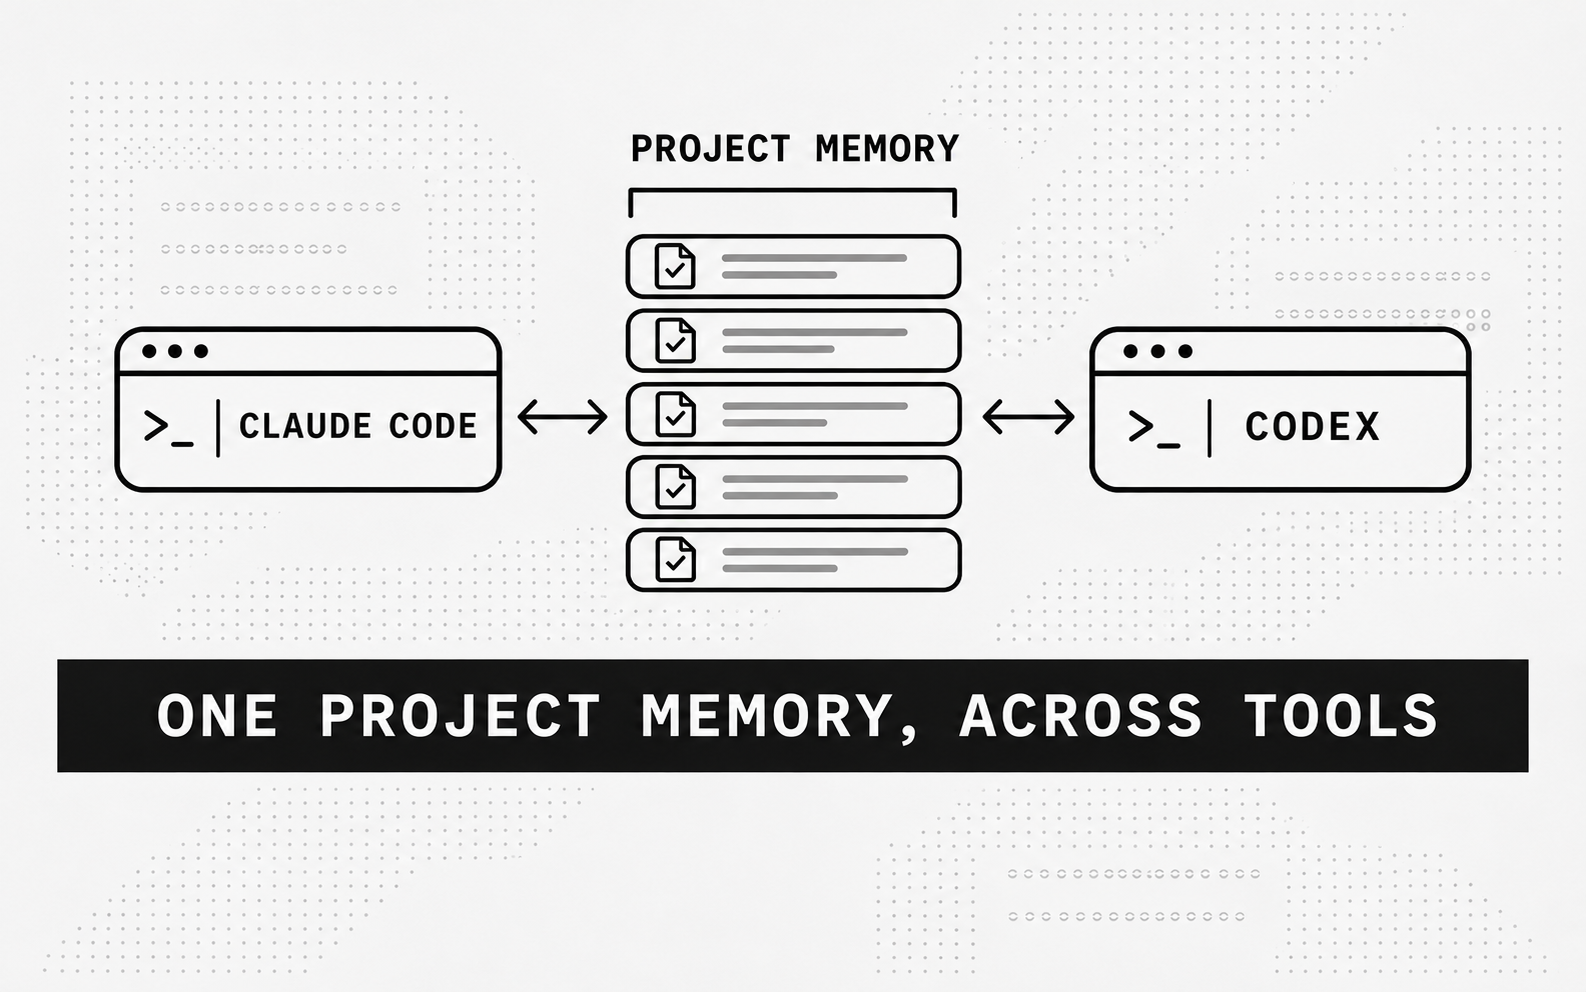
会写代码不等于理解项目
AI 编程助手已经可以生成函数、修复 Bug、编写测试和解释报错。
但当项目规模扩大之后,单纯提升代码生成能力并不能解决所有问题。
真实的软件项目通常包含大量文件、复杂依赖、多年的提交记录、历史 Issue、Pull Request、构建日志和内部开发规范。
如果 AI Agent 只能看到当前文件,它可能写出语法正确的代码,却无法判断这段代码是否符合项目结构,也无法理解过去为什么采用当前设计。
因此,代码智能的下一阶段,不只是让模型写出更多代码,而是让模型真正理解一个项目。
上下文窗口解决不了所有问题
扩大 LLM 的上下文窗口,能够让模型一次读取更多内容,但并不代表模型可以自动找到真正相关的信息。
大型代码库中的大多数文件与当前任务无关。如果将全部代码放入提示词,模型不仅需要处理大量噪声,还可能混淆新旧接口,误用已经废弃的实现。
上下文窗口解决的是容量问题,Code Memory 解决的是理解和管理问题。
一个完整的代码记忆系统需要知道当前任务涉及哪个模块,相关接口在哪里定义,过去是否出现过类似问题,以及最近的代码变化是否会影响当前修改。
什么是 Code Memory
Code Memory 是面向软件工程场景的长期记忆系统。
它不只是保存源代码,还需要保存代码之间的结构关系和开发过程中产生的历史信息。
代码结构包括模块、类、函数、接口、依赖和调用关系。项目历史包括 Issue、Pull Request、Commit 和重构记录。运行信息则包括测试结果、构建日志和部署反馈。
这些信息结合起来,才能帮助 Agent 理解代码为什么这样写,以及当前修改可能产生什么影响。
从文件级检索到仓库级理解
传统代码检索通常根据文件名、关键词或代码相似度返回若干片段。
但仓库级理解要求 Agent 进一步回答: 当前函数属于哪个模块?这个接口在哪里定义?它被哪些组件调用?过去是否发生过类似问题?某段代码是否在最近的重构中被替换?
这些问题不能只靠文本相似度解决。
Agent 需要同时利用代码结构、历史记录、任务描述和运行反馈,建立当前任务对应的项目上下文。
Stateless Agent 与 Context-Aware Agent
Stateless Agent 每次接收到任务时,只使用当前问题和当前代码。它不会主动检索历史 Issue,也不会访问过去的提交记录。
这种 Agent 适合简单的局部任务,但在大型项目中容易重复犯错。
Context-Aware Agent 则能够访问项目的长期上下文。它可以找到过去类似问题的解决方案,理解某段代码的历史原因,并根据项目已有规范提出新的修改。
两类系统的对比,能够帮助我们理解:AI Coding Agent 的性能提升,究竟来自更强的代码生成模型,还是来自更好的上下文管理和项目记忆。
一个完整的代码 Agent 工作流
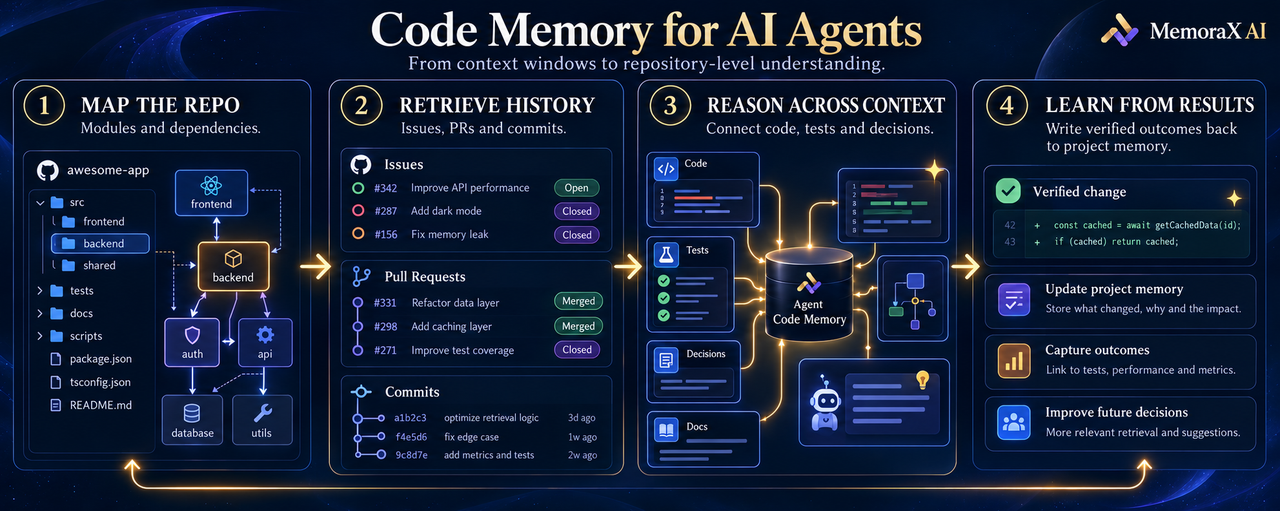
当用户提出一个新任务时,Agent 首先需要理解问题目标,然后定位可能涉及的模块和文件。
接下来,系统应该检索相关 Issue、Pull Request 和 Commit 记录,了解该模块过去发生过什么变化。如果任务涉及测试失败,还需要进一步读取构建日志和运行结果。
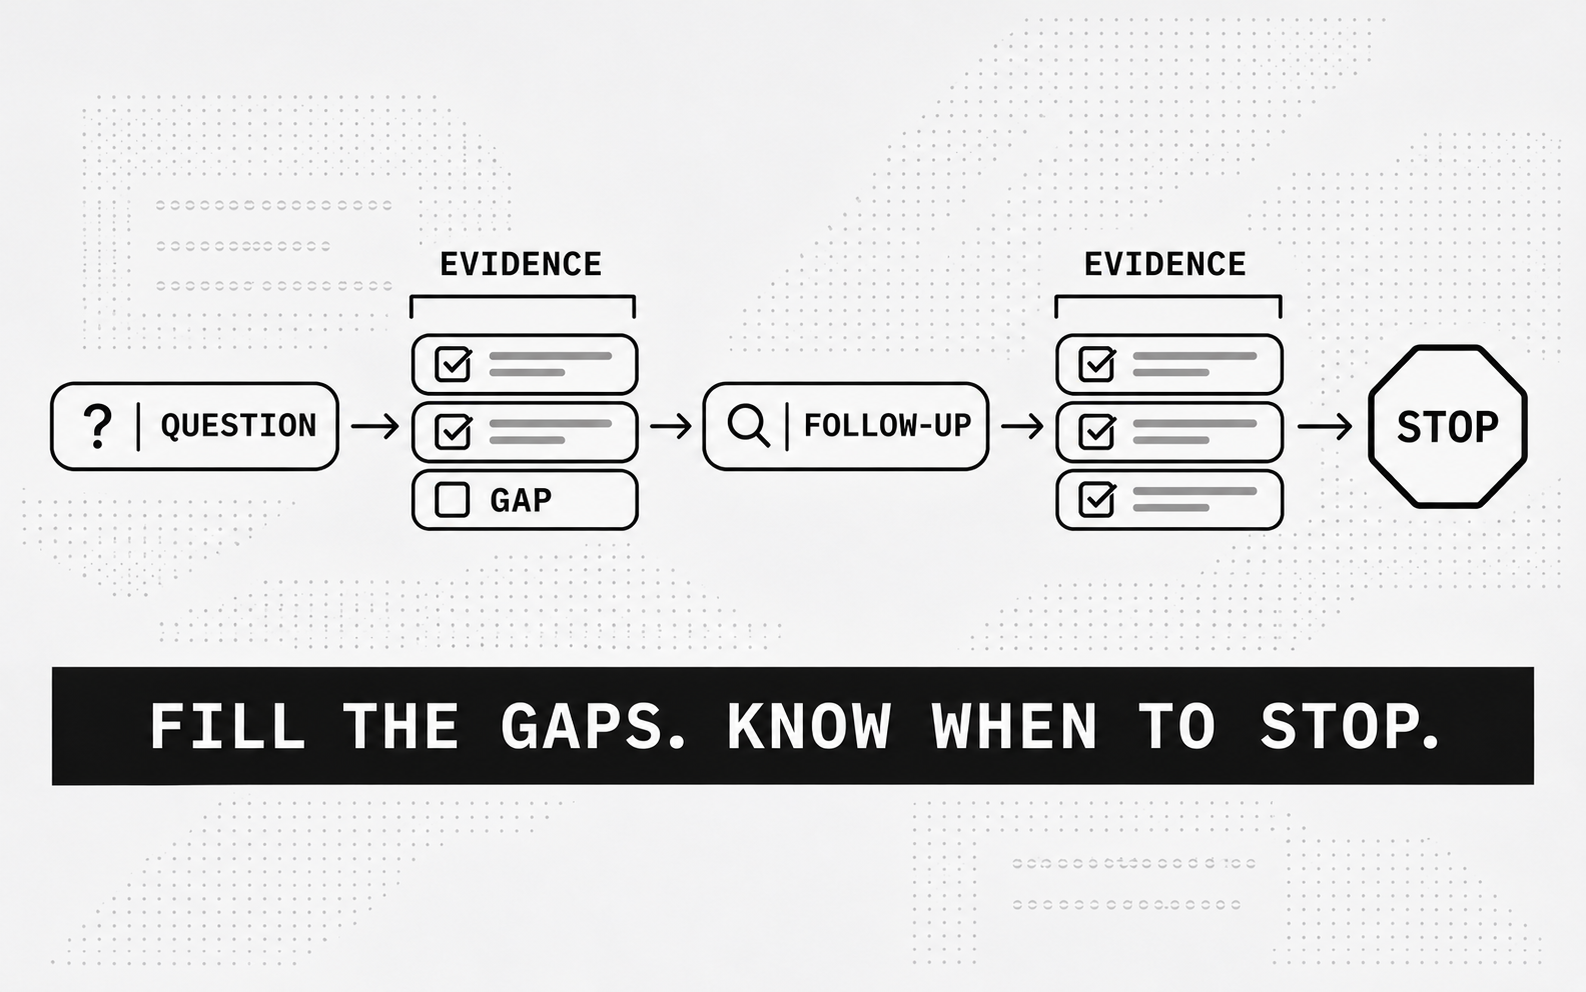
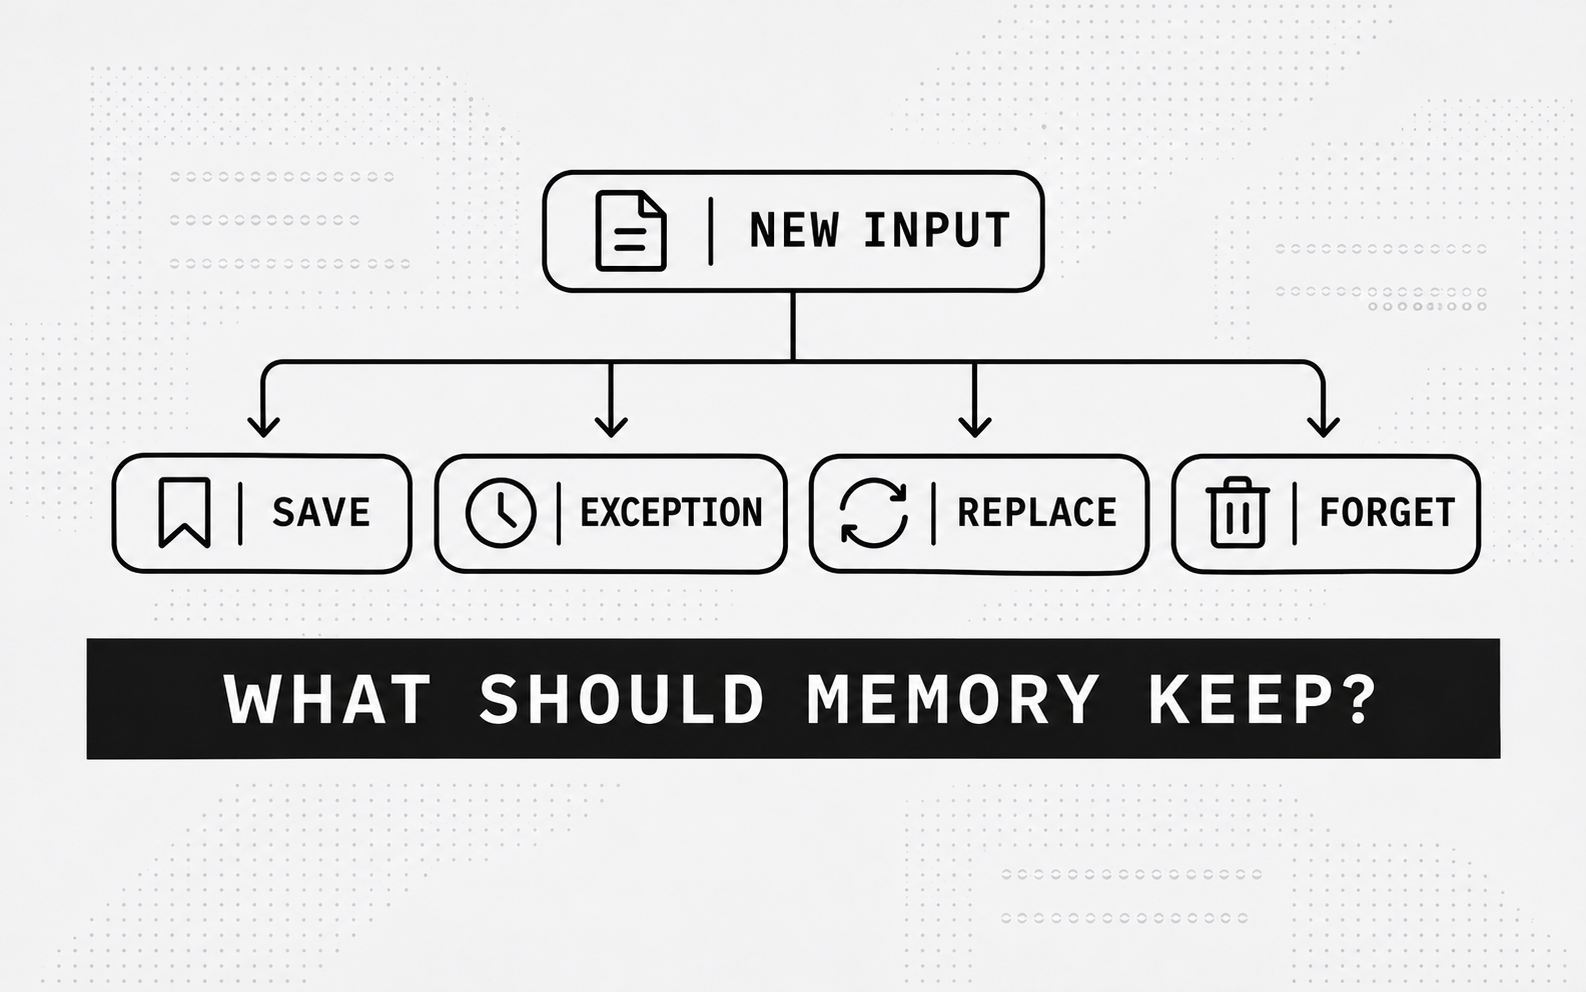
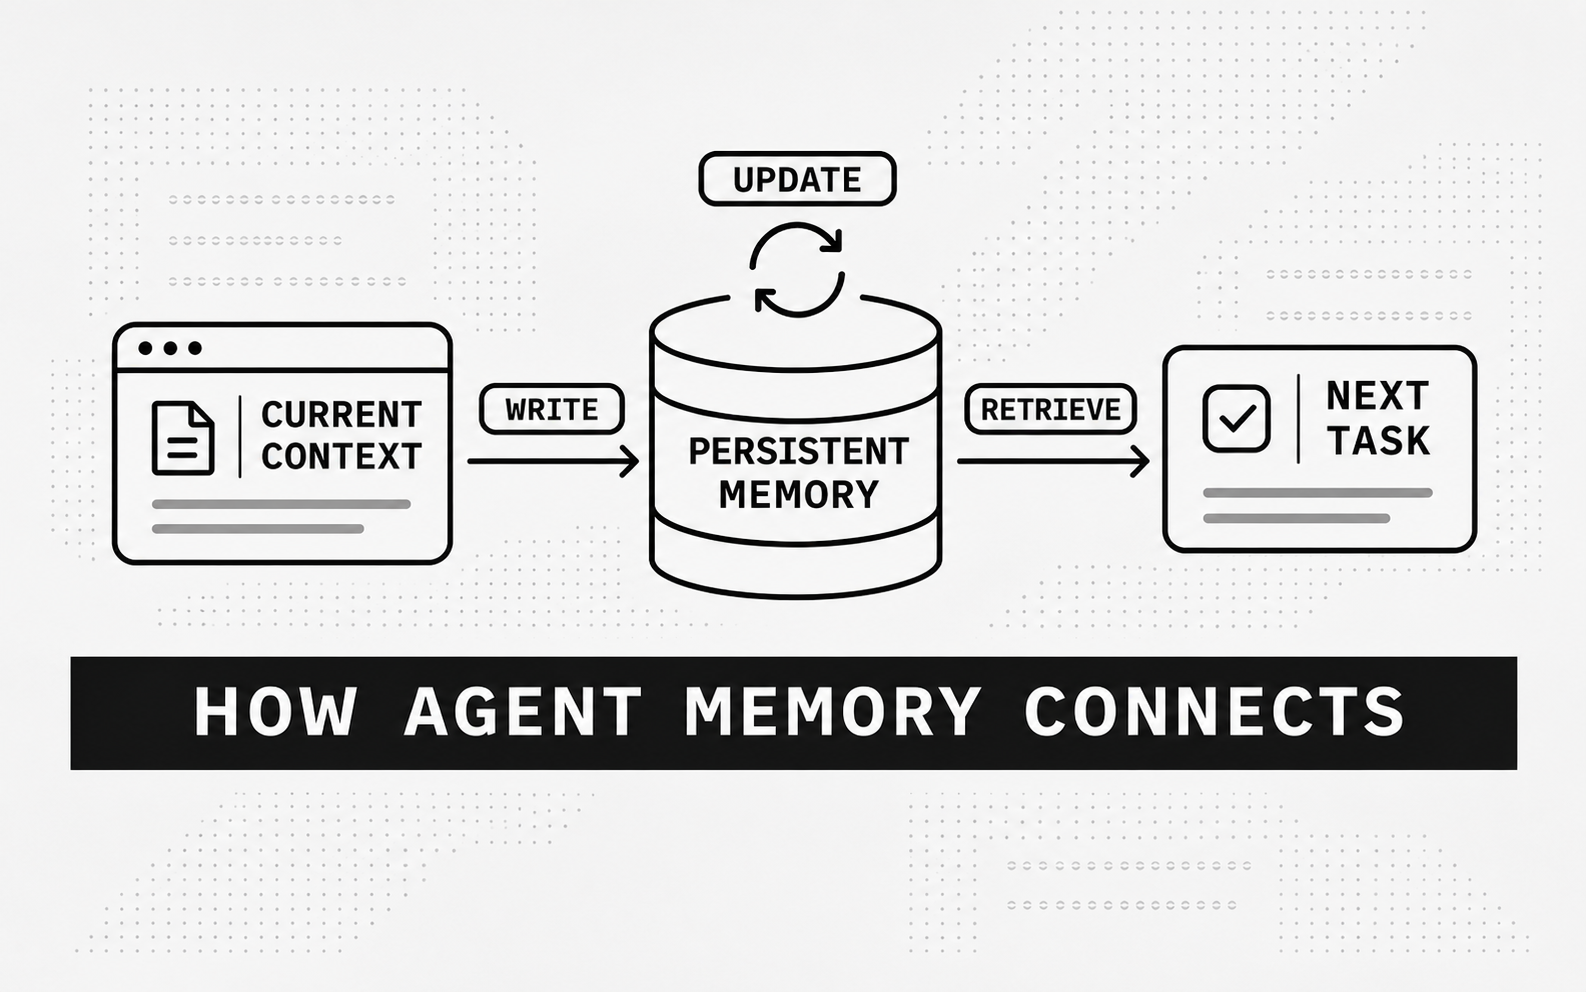
在完成这些信息整合之后,Agent 才能生成修改方案。代码修改完成后,新的测试结果和用户反馈还可以被写回项目记忆,帮助系统在未来处理类似问题。
这使 Agent 从一次性代码生成工具,逐渐变成能够持续参与项目的软件工程协作者。
如何评估代码记忆能力
代码 Agent 的评估不能只看最终代码是否通过测试。
还需要关注 Agent 是否找到了正确的项目上下文,是否理解了历史信息与当前任务的关系,是否复用了过去的解决方案,以及是否避免使用已经废弃的代码。
如果一个 Agent 最终解决了问题,但完全无法解释为什么采用某种修改方式,那么它的长期协作能力仍然有限。
AI Coding Agent 的下一阶段,不只是生成更多代码,而是理解更多项目背景。
Code Memory 可以帮助 LLM Agent 理解一个项目从哪里开始、经历过哪些变化,以及当前任务为什么需要采用某种解决方案。
MemoraX AI 认为,真正成熟的 AI 编程助手应该从短期代码生成工具,发展为能够持续学习、理解历史并长期参与软件工程工作的智能协作者。