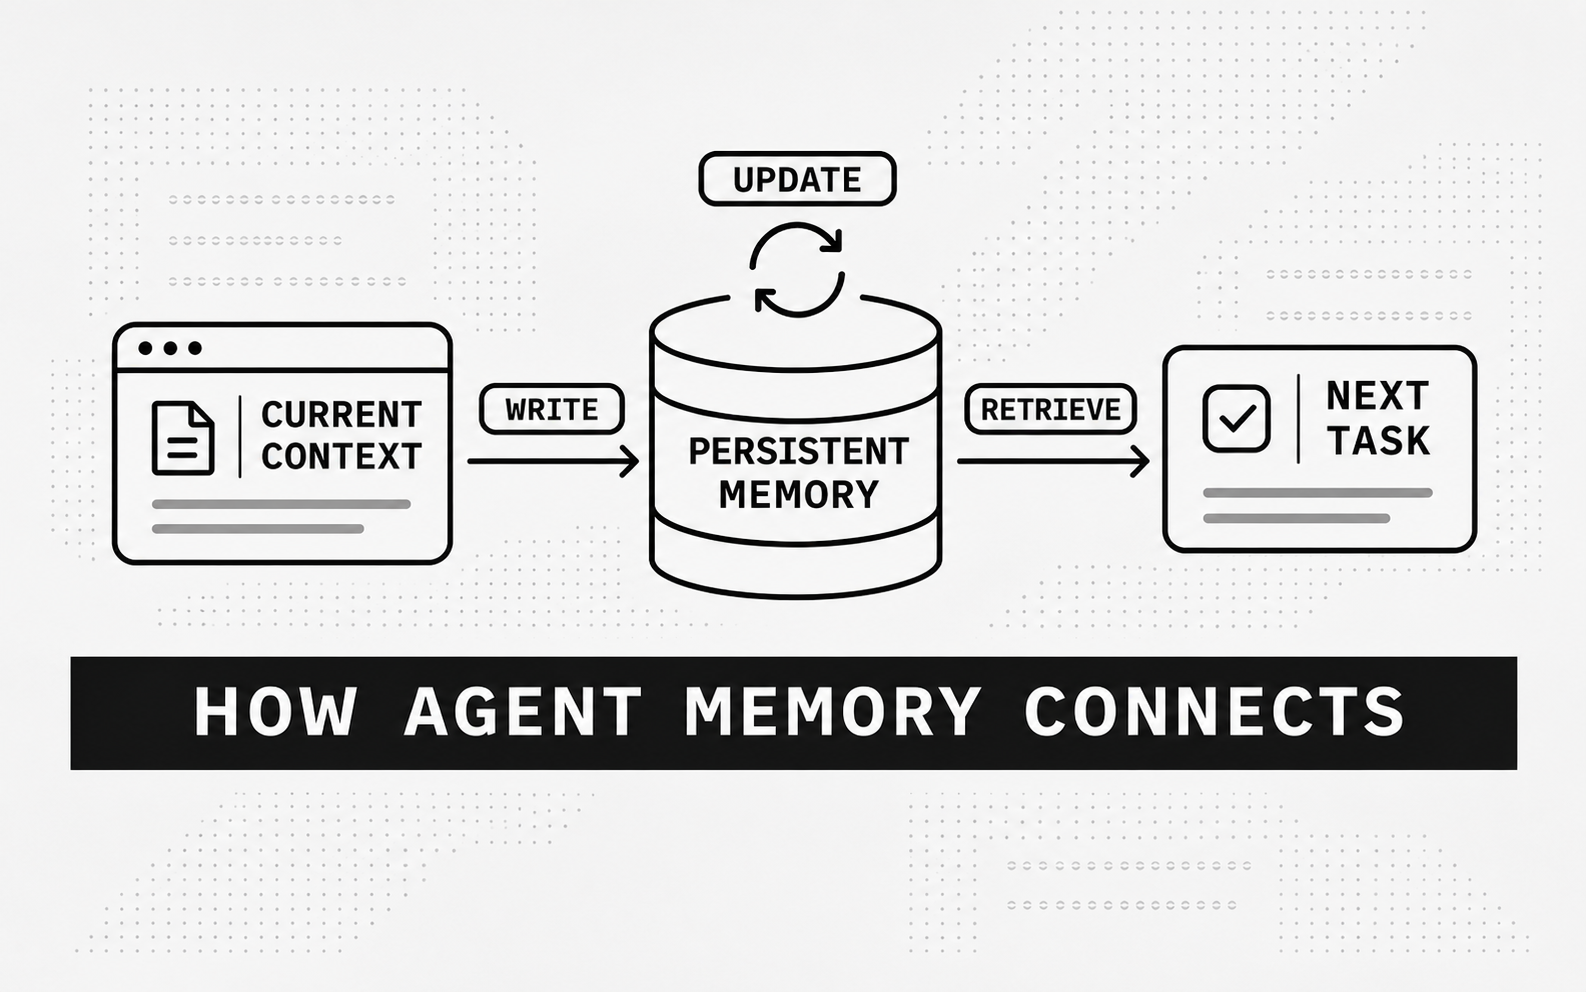
LLM 为什么需要 Memory
大语言模型能够在短时间内理解和生成大量信息,但它并不会像人一样自然地记住过去。
每次调用 LLM 时,模型主要依赖当前输入和上下文窗口中的内容。如果历史对话、用户偏好或项目资料没有被重新放入上下文,模型就无法直接使用这些信息。
因此,AI Agent 需要额外的 Memory 系统。
但 Memory 并不是简单地增加一个数据库。一个真正可用的 AI Agent Memory Architecture,需要处理信息的保存、分类、检索、更新、压缩和遗忘。
Context Window 与 Memory 的区别
Context Window 决定模型一次能够看到多少信息,Memory 决定系统能否在未来重新找到和使用过去的信息。 如果每次都把所有历史对话放入 Context Window,系统会遇到三个问题。
首先,输入长度会不断增加,带来更高的推理成本。其次,重要信息可能被大量无关内容淹没。最后,模型即使看到了所有内容,也不一定能够判断哪些信息真正重要。
Memory 的作用,就是将历史信息从连续对话中提取出来,经过筛选和组织后,在需要时重新提供给模型。
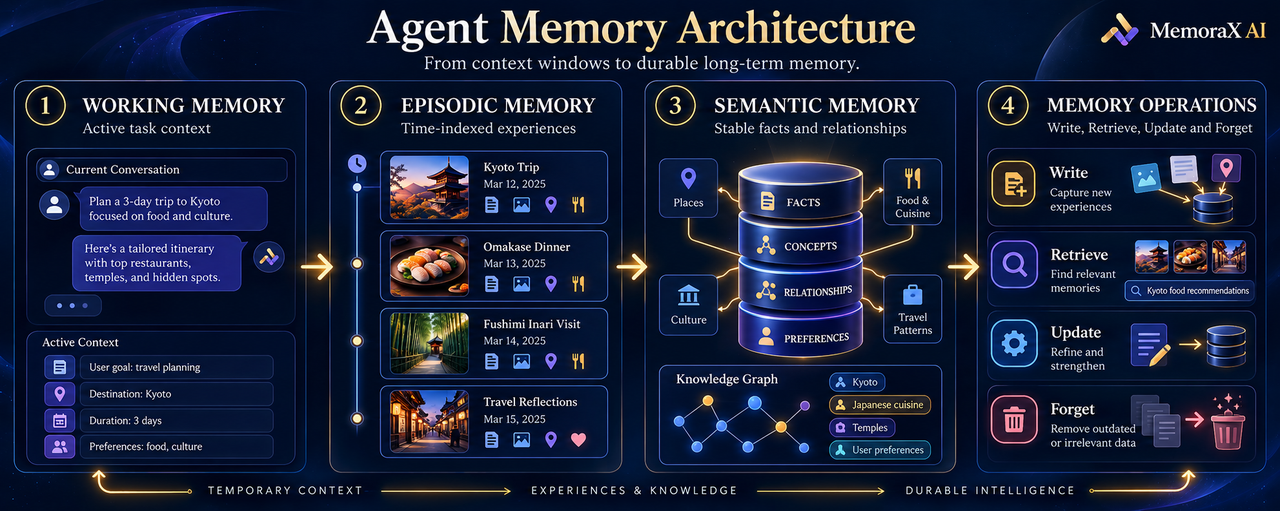
Working Memory:当前任务的临时空间
Working Memory 用于保存当前任务中的临时信息。
例如,Agent 正在处理一个复杂问题时,需要保存当前目标、最近几轮对话、正在执行的计划、临时检索结果和工具调用状态。
Working Memory 通常具有较短生命周期。任务结束之后,其中一部分信息可以被删除,另一部分则可以被总结并转化为长期记忆。
这使 Agent 能够在单个任务中保持连贯,同时避免把所有临时细节永久保存下来。
Episodic Memory:保存经历过的事情
Episodic Memory 用于保存具体经历和事件。
例如,用户过去完成过什么任务,Agent 曾经采取过什么行动,某个问题最后是如何解决的,以及之前的方案是否被用户接受。
这类记忆对长期协作非常重要。Agent 可以通过回忆过去的具体经历,避免重复犯错,也可以在类似任务中复用已经验证过的方法。
Semantic Memory:保存稳定知识
Semantic Memory 保存的是从多个事件中总结出的稳定事实和抽象知识。
例如,用户长期偏好某种输出格式,项目采用某种命名规范,企业内部有一套固定审批流程。
Semantic Memory 不一定保留完整对话,而是保存经过提炼后的知识。它更适合支持长期问答、用户个性化和业务规则执行。
Memory 的核心操作
一个完整的 Agent Memory 系统通常需要完成四种操作。
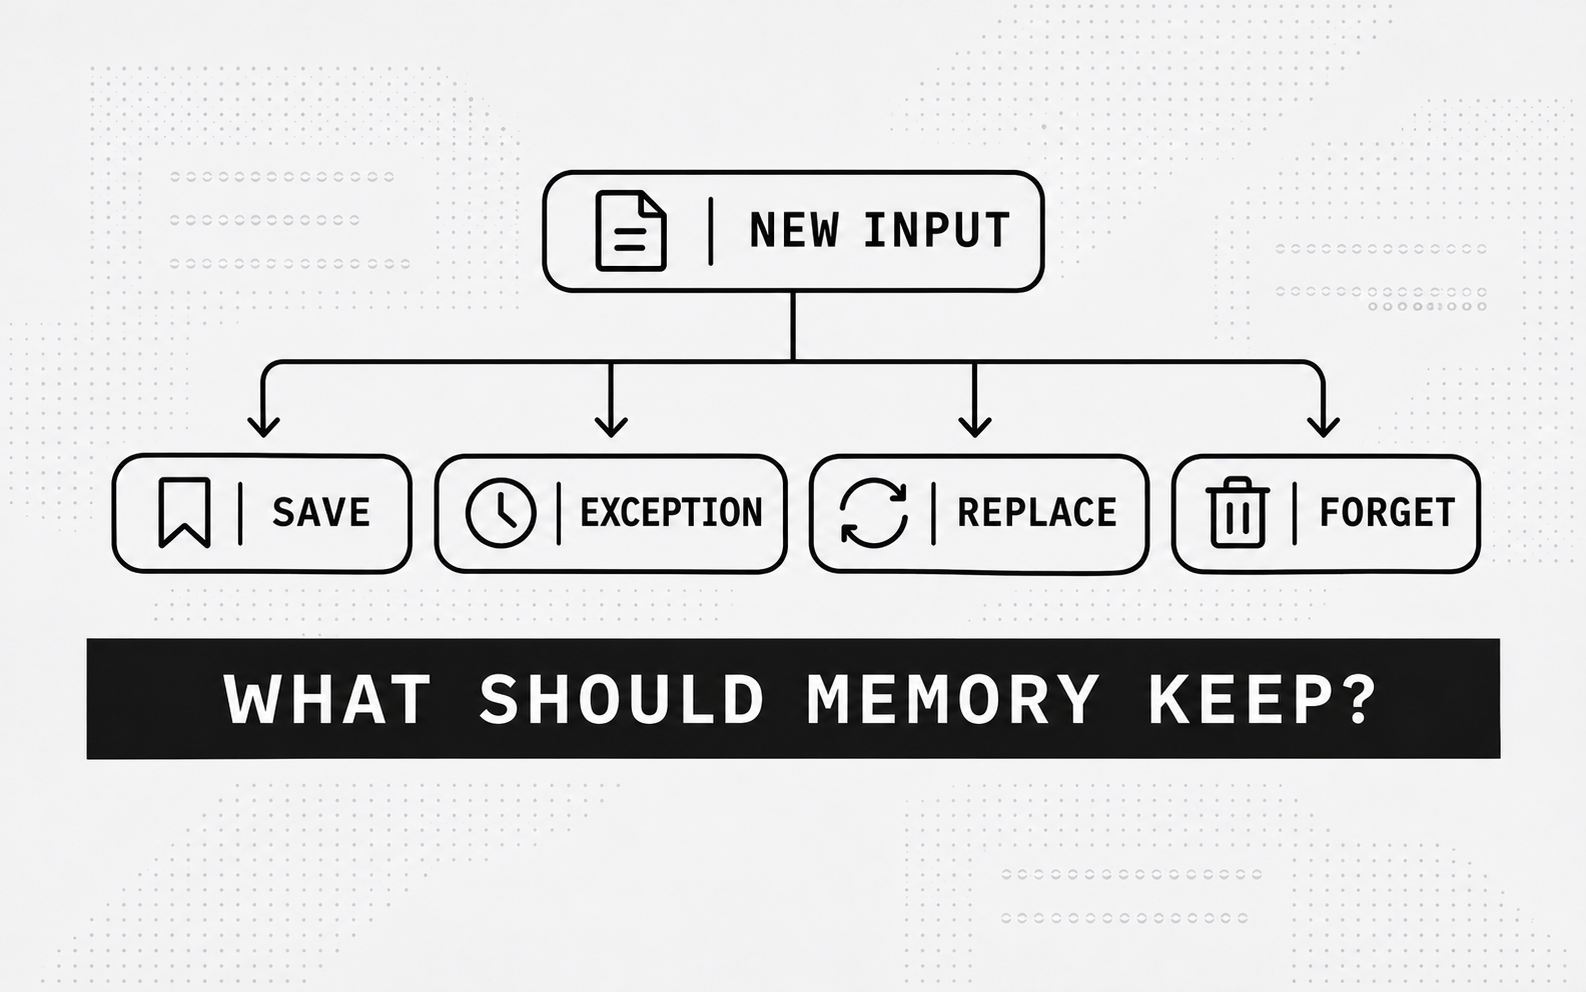
第一是 Write,也就是判断哪些内容值得写入长期记忆。第二是 Retrieve,根据当前任务找到真正相关的信息。第三是 Update,当新的事实出现时修正旧记忆。第四是 Forget,识别已经过时、错误或低价值的内容。
这四个操作相互影响。
如果 Write 阶段保存了太多无关信息,Retrieval 的质量会下降。如果 Update 机制不够及时,Agent 可能长期依赖错误内容。如果系统完全不会 Forget,记忆库最终会变成无法维护的历史日志。
为什么需要动态记忆
现实中的信息会持续变化。
用户的偏好可能改变,项目代码会不断更新,过去有效的解决方案也可能失效。因此,Memory 不能只负责保存内容,还需要判断信息是否仍然有效。
一个成熟的 Agent Memory 系统应该知道一条记忆的来源、时间、可信度和最近更新时间,并根据这些信息决定使用优先级。
MemoraX AI 的研究方向
MemoraX AI 关注的 Agent Memory,不只是保存更多信息,而是让记忆能够参与 Agent 的长期学习过程。
未来的 Memory 系统需要同时具备检索能力、结构化能力、反馈学习能力和长期更新能力。它应该帮助 Agent 在持续交互中变得更加准确,而不是单纯让数据库变得越来越大。
AI Agent Memory Architecture 的最终目标,不是让 Agent 记住一切,而是让 Agent 在需要时找到正确的信息,并且知道这些信息是否仍然值得使用。
随着 LLM Agent 从一次性问答走向长期协作,Memory 将逐渐从辅助模块变成智能体系统的核心基础设施。