真正的记忆不是记住一句话
随着 AI Agent 开始处理更长时间、更复杂的任务,Memory 已经成为衡量系统能力的重要指标。
但目前很多 Agent Memory Benchmark 仍然依赖短对话或合成数据。它们通常围绕一个简单事实设计问题,例如某个人说了什么、某件事发生在什么时候。
这类测试可以判断模型是否记住了一个信息,但无法完全反映真实交互中的复杂记忆。
在现实世界中,信息通常以关系网络的形式存在。
一个人物会参与多件事情,一件事件可能影响多个角色,一段关系也会随着时间变化。Agent 不仅要知道某件事情发生过,还需要理解事情之间的联系。
这正是 ScriptMem 试图解决的问题。
为什么合成对话不够
合成对话具有成本低、结构清晰和容易生成等优点,因此被广泛用于模型评测。
但合成对话往往缺少真实世界中的复杂性。
人物之间的关系可能比较简单,事件之间缺少长期影响,状态变化也通常不够自然。模型可能通过关键词匹配完成任务,却没有真正理解信息之间的关系。
对于长期运行的 AI Agent 来说,这种测试结果并不一定具有代表性。
一个 Agent 如果只能从短对话中找到明确事实,并不代表它可以在长期交互中保持稳定记忆。
ScriptMem 的数据构建思路
ScriptMem 基于高质量真实剧本构建评测数据。
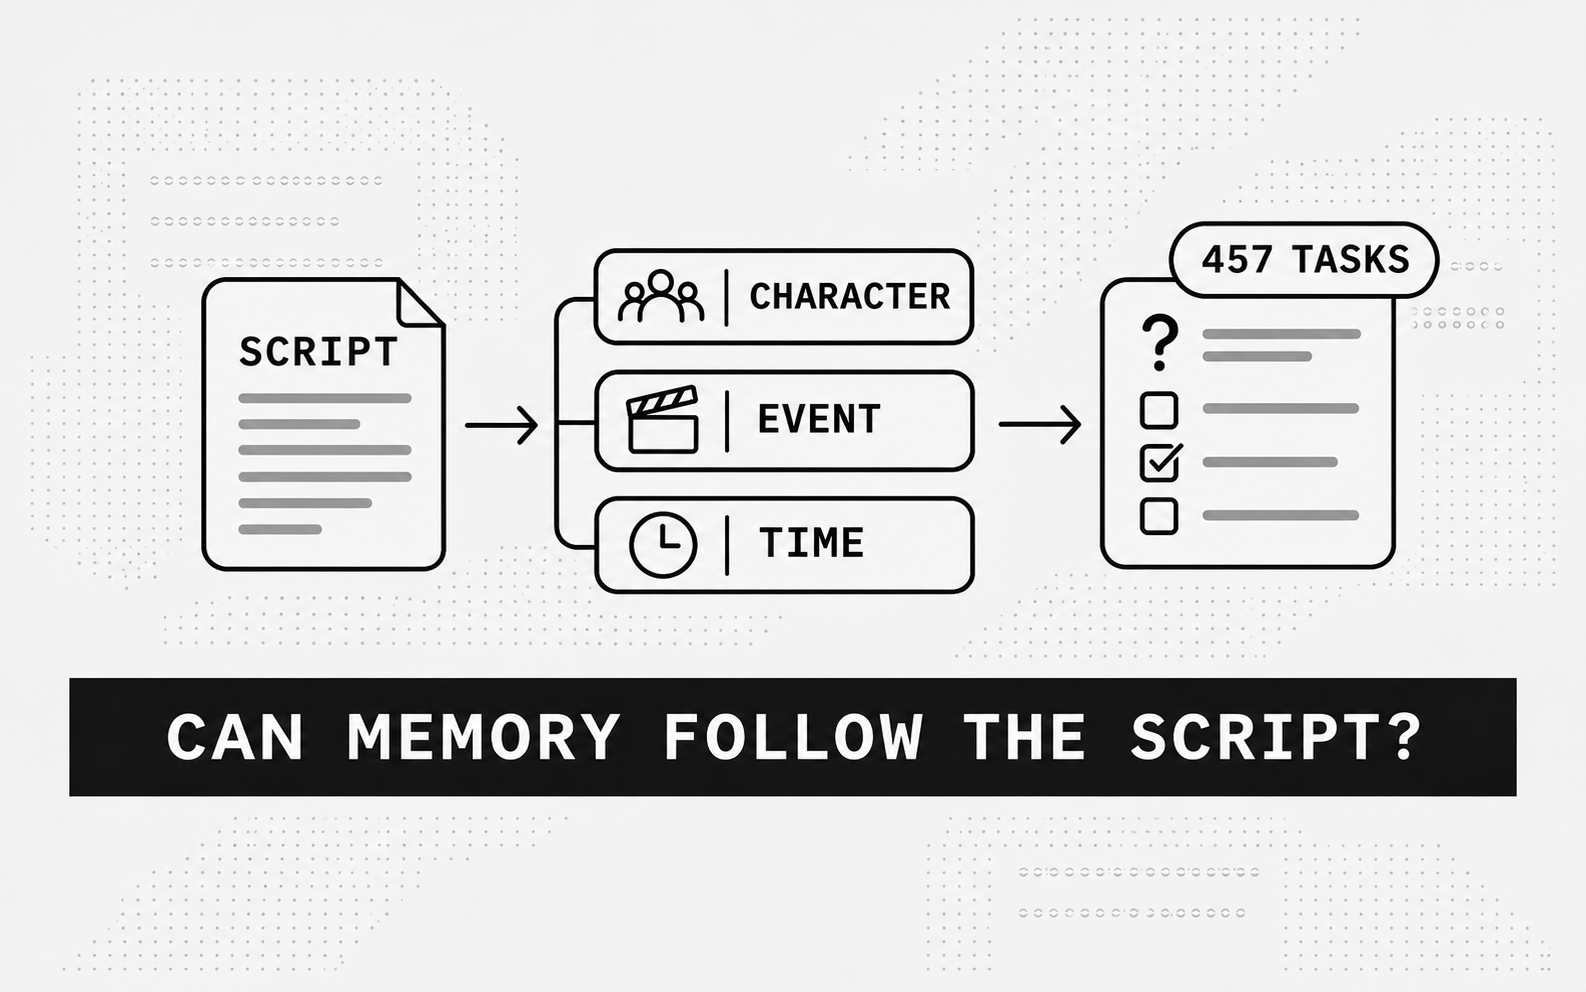
真实剧本通常包含丰富的人物关系、连续事件和明显的时间线。通过对剧本进行结构化分析,研究团队可以提取角色、事件、关系和状态变化,并以此生成不同类型的记忆问题。
这种构建方式带来了更接近真实任务的评测环境。
系统需要理解人物是谁,人物在不同阶段做过什么,哪些事件互相影响,以及某个状态在什么时候发生变化。
ScriptMem 共包含 457 道记忆评测问题,覆盖人物、事件、时间、关系和跨事件推理等多个维度。
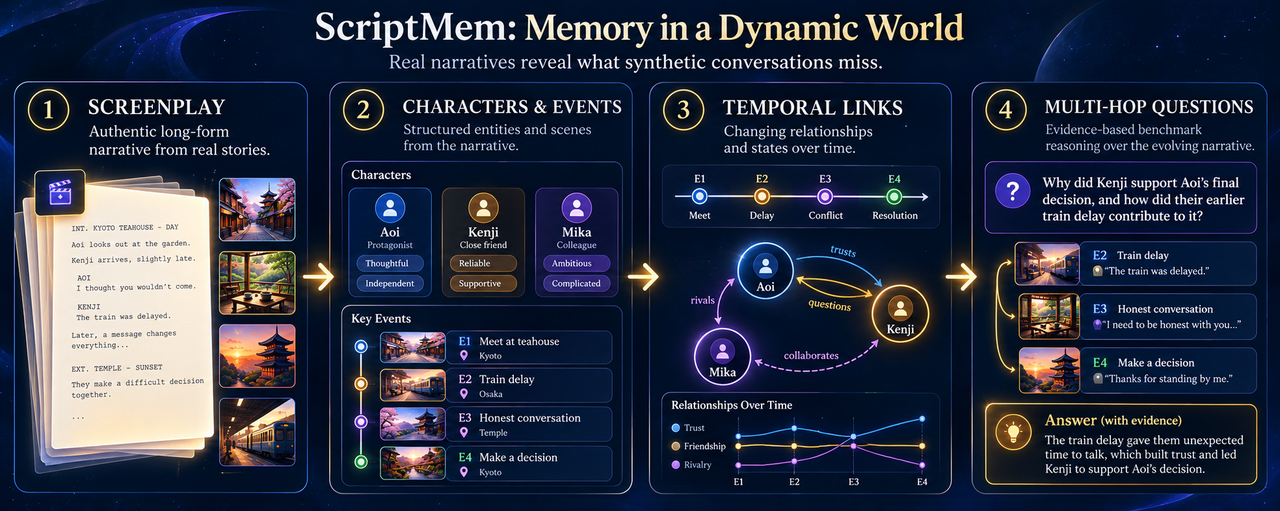
ScriptMem 评测的记忆能力
ScriptMem 不只是考察模型能否找到一条相关信息,而是考察 Agent 是否能够整合多条信息。
有些问题只需要一次检索即可完成,这属于单跳记忆。另一些问题则需要先找到人物,再找到人物参与的事件,最后根据时间顺序完成推理,这属于多跳记忆。
还有一些问题关注人物关系变化。例如,两个人在故事开始时是什么关系,经过某个事件之后又发生了什么变化。
这些任务要求 Agent 具备跨时间、跨事件和跨角色的综合理解能力。
实验结果说明了什么
在统一模型设置下,不同记忆系统表现出明显差异。
实验结果显示,MemoraX AI 的记忆系统取得了 60.3% 的准确率,相比第二名系统提升约 40%。
这一结果说明,真实剧本能够更有效地暴露 Agent Memory 系统的不足。
一些系统在简单事实检索上表现不错,但一旦问题涉及多个角色、多个事件和时间关系,性能就会明显下降。 这也说明,Agent Memory 的瓶颈并不总是检索能力,有时更可能是信息组织和关系推理能力。
Benchmark 对研究的价值
一个好的 Benchmark 不只是给模型排名,还应该帮助研究者发现问题。
ScriptMem 提供了一种更接近真实世界的评测方式,让研究者能够观察:
- Agent 是否理解长期信息;
- 是否能够追踪人物和事件;
- 是否能够处理状态变化;
- 是否会被过时信息误导;
- 是否能在复杂关系中保持一致性。
对于 MemoraX AI 来说,Benchmark 的价值不仅在于展示系统性能,也在于帮助研究团队理解当前 Agent Memory 仍然缺少什么。
未来的 Agent Memory 评测
未来的 AI Agent 需要在长期对话、软件工程、知识问答和任务协作中持续工作。
这些场景都要求系统不仅保存信息,还要理解信息之间的结构和变化。
因此,未来的 Memory Benchmark 可能需要进一步加入:
- 更长时间跨度;
- 多模态信息;
- 多用户协作;
- 工具调用记录;
- 动态环境变化;
- 用户反馈和偏好变化。
ScriptMem 希望推动 Agent Memory 评测从“是否记住一个事实”,走向“是否理解一个动态世界”。 对于 LLM Agent 来说,真正的长期记忆不是保存更多文本,而是在持续变化的信息中保持连贯、准确和可更新的理解。